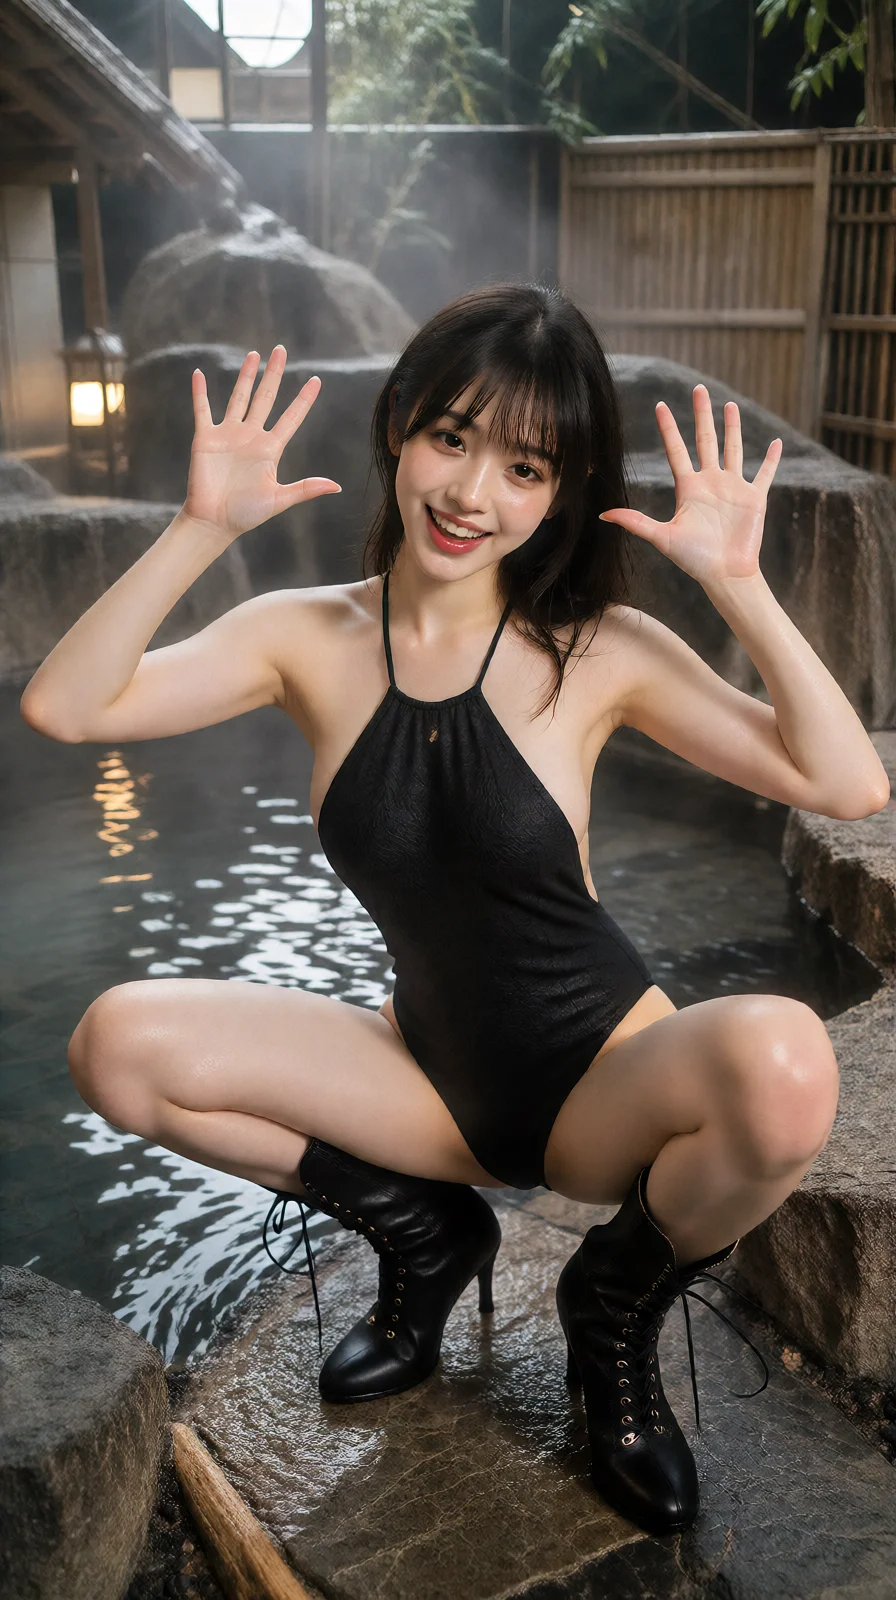
Night Onsen Rotenburo Portrait - RedCraft Hybrid H3 & Krea2T Photorealism
8st · euler 896×1600 10GB
Runs entirely in VRAM with no memory swapping.
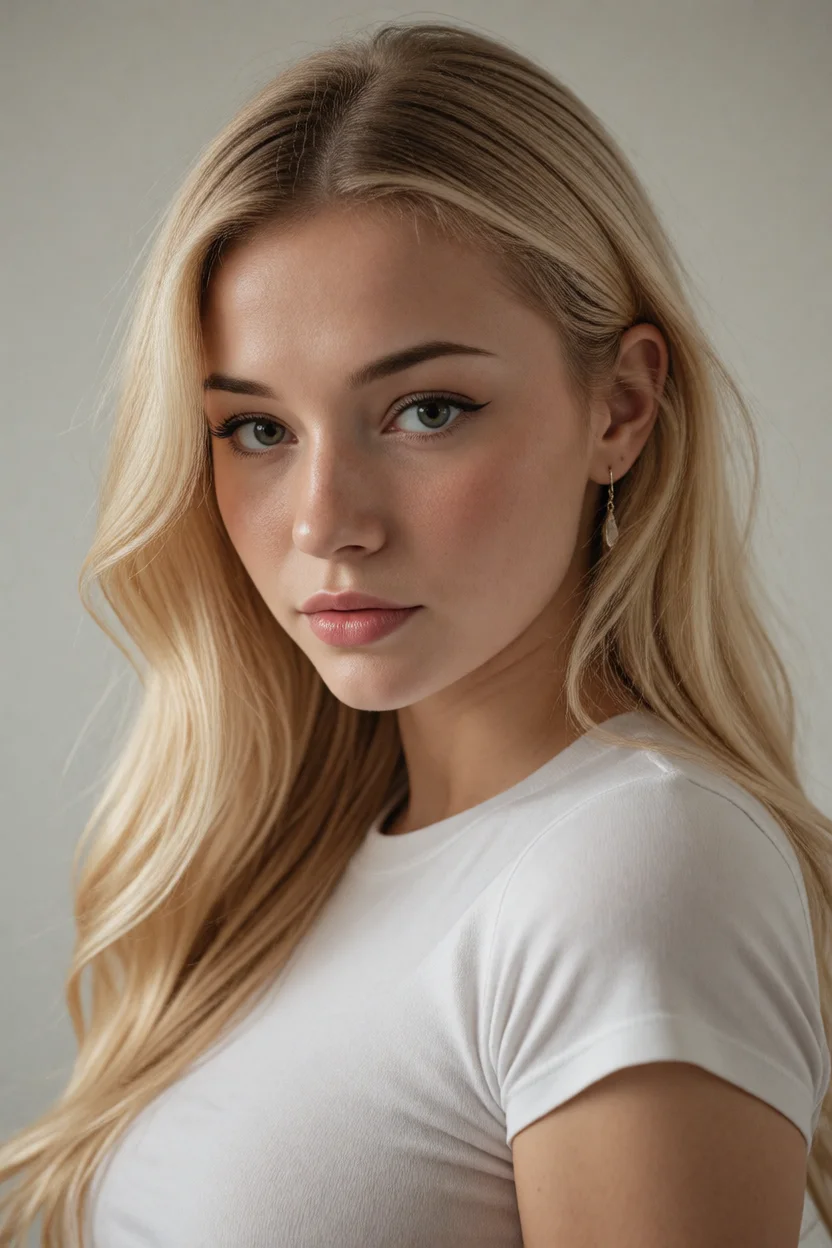
High-resolution studio portrait of Dahlia deconstructed from Civitai #144401284 by TeeKay using Krea 2 Turbo FP8, Wan 2.1 16-channel VAE, and a 3-LoRA character stack.
Reproducible ComfyUI workflow for Civitai #144401284: Dahlia Editorial Studio Portrait - Krea 2 Turbo using Krea 2 Turbo (FP8 Scaled DiT) at 832×1248 resolution. Requires minimum 12GB VRAM with sampler euler and scheduler simple (8 steps). Includes 1-click terminal model sync and canvas JSON graph.
Run in your ComfyUI root:
curl -fsSL https://decomfy.com/api/scripts/civitai-dahlia-blonde-studio-krea2.sh | bash Loading bash setup script... Loading PowerShell setup script... import modal
app = modal.App("comfyui-civitai-dahlia-blonde-studio-krea2")
vol = modal.Volume.from_name("comfy-weights-cache", create_if_missing=True)
image = (
modal.Image.debian_slim(python_version="3.11")
.apt_install("git", "wget", "curl", "libgl1-mesa-glx", "libglib2.0-0")
.pip_install("torch", "torchvision", "--index-url", "https://download.pytorch.org/whl/cu124")
.pip_install("transformers", "accelerate", "safetensors", "aiohttp")
.run_commands(
"git clone https://github.com/comfyanonymous/ComfyUI.git /root/ComfyUI",
"cd /root/ComfyUI && pip install -r requirements.txt",
)
)
@app.function(
gpu="A10G",
image=image,
volumes={"/root/ComfyUI/models": vol},
timeout=900,
)
def generate():
# Headless serverless execution for Krea 2 Turbo (FP8 Scaled DiT)
print("Executing Civitai #144401284: Dahlia Editorial Studio Portrait - Krea 2 Turbo on ephemeral A10G GPU...")
return {"status": "success", "slug": "civitai-dahlia-blonde-studio-krea2"}
runpodctl create pod \
  --name "comfy-civitai-dahlia-blonde-studio-krea2" \
  --gpu-type "NVIDIA RTX 4090" \
  --image "runpod/comfyui:latest" \
  --volume-in-gb 50 \
  --ports "8188/http"
# ComfyUI Model Batch Ingestion for Civitai #144401284: Dahlia Editorial Studio Portrait - Krea 2 Turbo
# Run with: aria2c -i models-civitai-dahlia-blonde-studio-krea2.txt -j4 -x4
https://civitai.com/api/download/models/3072332
dir=models/diffusion_models
out=krea2_turbo_fp8_scaled.safetensors
https://civitai.com/api/download/models/3277993
dir=models/text_encoders
out=krea2_solordz_te_int8.safetensors
https://huggingface.co/Comfy-Org/Wan_2.1_ComfyUI_repackaged/resolve/main/split_files/vae/wan_2.1_vae.safetensors
dir=models/vae
out=wan_2.1_vae.safetensors
https://civitai.com/api/download/models/3375434
dir=models/loras
out=Character_Mix_DahliaMixer_Kr2.safetensors
https://civitai.com/api/download/models/3290120
dir=models/loras
out=Kr2_snofs_krea_v1_4.safetensors
https://civitai.com/api/download/models/3075498
dir=models/loras
out=Kr2_Emotions V1.safetensors This workflow requires a minimum of 12GB VRAM (recommended 16GB VRAM). Tested and verified on NVIDIA GeForce RTX 4070 (12GB VRAM) at 832x1248 resolution.
You can drop the workflow JSON into our client-side Missing Node Auto-Resolver at https://decomfy.com/resolve/ to detect missing nodes and generate install commands, or run the 1-click terminal setup script provided below.
Krea 2 DiT single-stream models strictly require the 16-channel Wan2.1 VAE and Qwen3-VL text encoder. Using standard Flux or SDXL VAE causes inverted checkerboard artifacts. Also pair with RescaleCFG for high-contrast portrait clarity.